Un modèle de prévision de la demande ne réduit les stocks d'un commerce que si trois conditions sont réunies : au moins deux ans d'historique de ventes par référence et par point de vente, les ruptures passées identifiées comme telles et non comptées comme une absence de demande, et une décision de réapprovisionnement qui reste validée par un humain sur les références qui comptent. Sans ces conditions, le modèle prédit le passé et l'acheteur cesse de le regarder. Voici ce qu'il faut avoir, ce qu'un modèle mesure réellement, la façon d'enchaîner prévision et commande, et par quelles références commencer, pour une enseigne, un e-commerçant ou une maison de luxe.
Ce que la prévision change, et ce qu'elle ne change pas
Un réapprovisionnement classique repose sur des seuils fixes par référence, révisés à la main quelques fois par an. Un modèle de prévision calcule, pour chaque référence et chaque point de vente, la demande attendue sur l'horizon de réapprovisionnement, en tenant compte de la saisonnalité, des promotions, des jours fériés et de la tendance récente. Il transforme un seuil figé en un seuil qui bouge chaque semaine. Ce qu'il ne change pas : la décision d'acheter, le budget, les contraintes fournisseurs et les arbitrages sur les nouveautés, qui n'ont pas d'historique. Bpifrance Le Lab relève dans son enquête auprès de 1 200 dirigeants que 43 % des PME et ETI n'analysent pas leurs données pour piloter l'activité ; dans le commerce, ces données existent presque toujours dans l'outil de caisse, et c'est la première chose à vérifier.
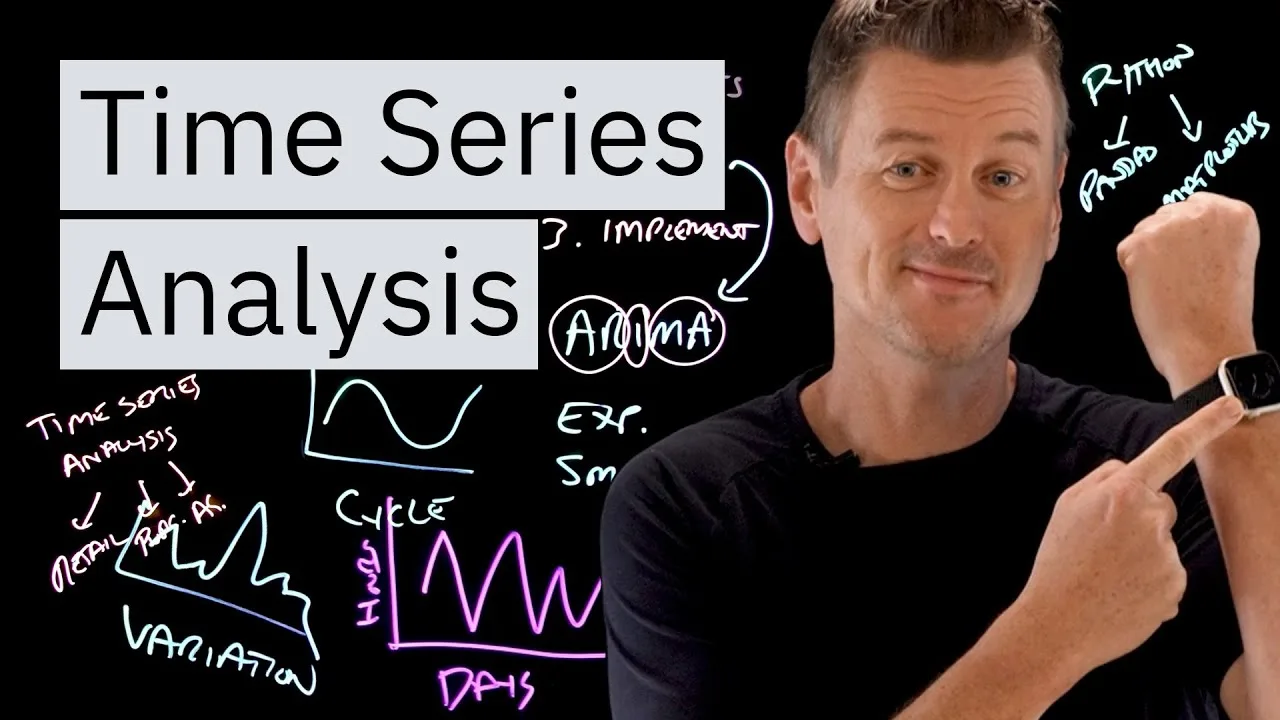
Résumé de la vidéo (en anglais) : IBM Technology explique ce qu'est une série temporelle, comment on y lit tendance, saisonnalité et bruit, et pourquoi la prévision dépend d'abord de la qualité et de la profondeur de l'historique.
Ce qu'il faut avoir avant de commencer
Deux ans d'historique par référence et par point de vente. Un an ne permet pas de distinguer la saisonnalité d'un accident. Les références de moins d'un an se prévoient par analogie avec des références comparables, pas par leur propre historique.
Les ruptures identifiées. Une référence en rupture pendant trois semaines affiche zéro vente ; un modèle qui lit ce zéro comme une absence de demande prévoit une demande trop basse et reconduit la rupture. Il faut un signal de disponibilité, même approximatif, à côté des ventes.
Le calendrier des promotions et des événements. Une opération commerciale passée doit être connue du modèle pour ne pas être lue comme une tendance ; une opération à venir doit lui être fournie pour être anticipée.
Un référentiel produit propre. Une référence qui change de code à chaque saison casse l'historique. Le rattachement des codes successifs est un travail de données avant d'être un travail de modèle. L'outil Prophet, documenté par ses auteurs, illustre ce que demande un modèle de prévision : une série datée, des jours fériés, des régresseurs comme les promotions.
Ce qu'un modèle mesure, et les trois chiffres à exiger
| Chiffre | Ce qu'il dit | Ce qu'il faut demander |
|---|---|---|
| Erreur moyenne de prévision, par classe de référence | L'écart entre prévu et vendu, une fois les ruptures exclues | Par classe ABC, pas en moyenne globale : une erreur de 15 % sur les meilleures ventes et de 60 % sur la longue traîne est normale |
| Biais | Si le modèle sur-prévoit ou sous-prévoit systématiquement | Proche de zéro sur les meilleures ventes ; un biais positif fabrique du stock dormant |
| Taux de rupture et stock dormant, avant et après | Le résultat métier, le seul qui compte | Mesurés sur les mêmes références, sur une saison complète |
Un fournisseur qui annonce une précision globale sans distinguer les classes de références et sans exclure les ruptures n'a pas répondu. Le chiffre qui décide est la troisième ligne, et il demande une saison.
De la prévision à la commande : où reste l'humain
La prévision alimente une proposition de commande par référence et par fournisseur, qui tient compte du stock actuel, des encours, du délai fournisseur, du conditionnement et de la couverture cible. L'acheteur voit la proposition, la raison (prévision, saisonnalité, promotion), et valide, ajuste ou refuse. Sur les références de classe C, à faible enjeu, la validation peut devenir automatique après une saison de comparaison. Sur les classes A et B, elle reste humaine : c'est là que se jouent la marge et l'image, et c'est là que les nouveautés, les fins de série et les décisions commerciales que le modèle ne connaît pas interviennent. Le principe est celui d'un copilote intégré à l'outil de gestion, qui propose et laisse décider, comme le décrivent les exemples d'agents IA déployés en PME.
Le commerce unifié : un seul stock, plusieurs canaux
Quand une enseigne vend en magasin, sur son site et sur des places de marché, la prévision par canal seul se trompe : une promotion en ligne vide le stock d'un magasin qui sert d'entrepôt de proximité. La prévision se fait par référence et par lieu de stockage, avec la demande de chaque canal comme régresseur, et la proposition de commande tient compte des transferts possibles entre lieux. C'est un travail de données avant d'être un travail de modèle : sans un stock unique lisible en temps réel par lieu, aucune prévision ne tient.
Le cas particulier du luxe et des nouveautés
Une maison qui vend peu de pièces d'une référence, avec des lancements fréquents, n'a pas d'historique exploitable par référence. La prévision se fait alors par attributs, catégorie, matière, gamme de prix, saison, en apprenant sur les lancements passés ce qu'un nouveau produit comparable a vendu. La précision est plus faible et la validation humaine plus large, mais le modèle apporte ce que l'intuition seule ne donne pas : la comparaison systématique avec tous les lancements passés, pas seulement ceux dont on se souvient. L'article sur l'IA sur mesure pour le vin et le luxe développe ce point.
Par quelles références commencer
Par la classe A d'un seul point de vente ou d'un seul entrepôt : les références qui font l'essentiel du chiffre d'affaires, avec un historique profond et des ruptures identifiables. Une saison en parallèle de la méthode actuelle, où le modèle propose et l'acheteur compare, puis la mesure sur le taux de rupture et le stock dormant. L'extension aux autres classes et aux autres sites vient après. Les enseignes qui commencent par « toutes les références » passent la première saison à nettoyer le référentiel produit au lieu de mesurer.
Pourquoi les projets de prévision sont débranchés
Compter les ruptures comme une absence de demande, ce qui fait reconduire les ruptures. Juger le modèle sur une précision globale, qui mélange les meilleures ventes et la longue traîne. Et automatiser la commande sur les classes A dès la première saison : la première rupture sur une référence phare suffit à faire débrancher l'outil.
Du référentiel produit à la commande validée
Le cadrage commence par les données de caisse et le référentiel produit, avec un échantillon de références de classe A et la reconstitution des ruptures passées. Puis un modèle mesuré par classe, une proposition de commande intégrée à l'outil de gestion, une saison en parallèle et la mesure sur le taux de rupture et le stock dormant. C'est le périmètre de l'accompagnement JUWA pour le retail, l'e-commerce et le luxe, du référentiel produit à la commande validée.