Une application d'IA en production, agent, copilote ou assistant documentaire, se dégrade sans que personne ne change une ligne de code : les documents indexés vieillissent, les questions des utilisateurs évoluent, le fournisseur met à jour son modèle, le coût par requête dérive. Le LLMOps, c'est l'ensemble des pratiques qui permettent de le voir avant les utilisateurs, et de corriger sans repartir de zéro. Tout ce qui suit porte sur ce qu'il faut surveiller après la mise en production, avec quels indicateurs, comment versionner ce qui change, et ce que JUWA mesure sur ses propres déploiements.
Pourquoi une application LLM se dégrade sans changement de code
Quatre causes, dans l'ordre de fréquence. La base de connaissances change : un document est ajouté, un autre périmé reste indexé, et l'assistant cite une procédure remplacée. Les usages changent : les utilisateurs posent des questions que le jeu de test ne contenait pas, ou dans un vocabulaire différent. Le modèle change : le fournisseur publie une nouvelle version derrière le même nom d'API, et une consigne qui tenait ne tient plus. Le coût dérive : une requête qui remonte dix fois plus de contexte qu'en cadrage coûte dix fois plus, sans que personne ne l'ait décidé. Aucune de ces causes n'est une panne ; aucune ne déclenche une alerte classique. C'est ce qui rend le LLMOps nécessaire, comme le décrit IBM dans sa définition du LLMOps, distinct du MLOps par la place du prompt, du contexte et de l'évaluation en langage naturel.
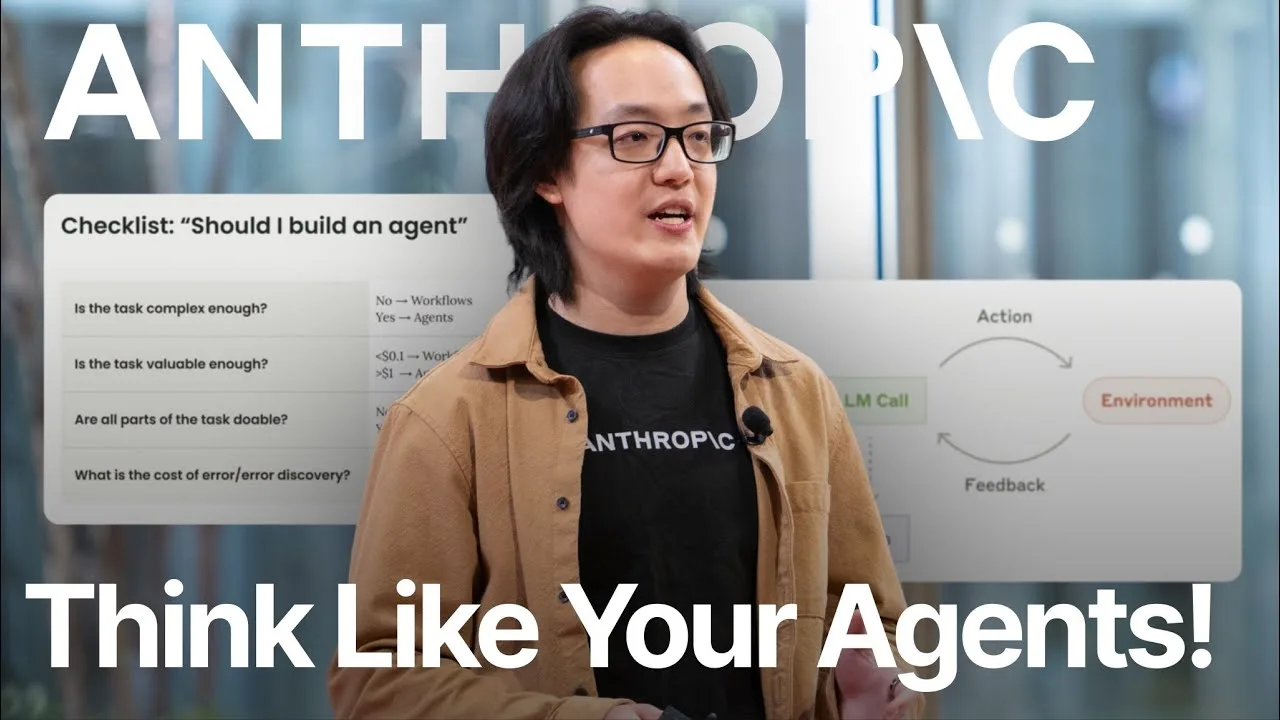
Résumé de la vidéo (en anglais) : Barry Zhang, de l'équipe Applied AI d'Anthropic, sur ce qui sépare une démonstration d'un agent qui tient en production : rester simple, tester du point de vue de l'agent, et instrumenter chaque appel d'outil.
Le jeu de test : la pièce centrale, avant et après la mise en production
Cinquante à deux cents questions réelles, avec la réponse attendue et la source, écrites avec le métier avant la mise en production. C'est ce jeu qui mesure la qualité au cadrage, et c'est le même jeu, rejoué chaque semaine ou à chaque changement, qui détecte la dégradation. Les guides d'Anthropic et d'OpenAI sur l'évaluation décrivent la même mécanique : des cas définis, un score par cas, une comparaison avant et après tout changement de modèle, de prompt ou d'index. Un jeu de test qui n'est pas rejoué après la mise en production n'a servi qu'une fois. Les métriques d'évaluation d'un RAG détaillent les scores utiles.
Les indicateurs à suivre en production
| Indicateur | Ce qu'il détecte | Seuil d'alerte typique | Correction |
|---|---|---|---|
| Score sur le jeu de test, rejoué chaque semaine | Dégradation du modèle, du prompt ou de l'index | Baisse de plus de 5 points | Comparer les versions, revenir à la précédente |
| Taux de transfert humain ou de « je ne sais pas » | Questions hors périmètre, base incomplète | Hausse de 20 % sur une semaine | Lire les questions transférées, enrichir la base ou le périmètre |
| Part de réponses sans source citée | Réponses générées hors documents | Toute valeur non nulle sur un RAG | Renforcer le garde-fou, réindexer |
| Latence de bout en bout | Index trop lourd, contexte trop long, fournisseur lent | Au-delà du seuil fixé au cadrage (souvent 3 s) | Réduire le contexte, changer de modèle pour la tâche |
| Coût par requête et par client | Dérive de contexte, boucles d'agent | Hausse de 30 % sans hausse d'usage | Plafonner le contexte, limiter les itérations |
| Retours utilisateurs négatifs | Ce que les autres indicateurs ne voient pas | Chaque retour lu | Ajouter le cas au jeu de test |
Chez un éditeur SaaS accompagné par JUWA, deux de ces indicateurs étaient les critères de succès du cadrage : 95 % des interactions sans intervention humaine et moins de trois secondes de latence, sur deux millions de messages mensuels. Ce sont les mêmes chiffres qui servent depuis à la surveillance : un critère de succès qui n'est pas suivi après la livraison n'était qu'un argument de vente.
Le journal : ce qu'il doit contenir
Pour chaque requête : la question, le contexte récupéré (quels documents, quelles versions), les appels d'outils avec leurs paramètres et leurs réponses, la réponse produite, le modèle et sa version, le coût, la latence, et l'éventuel retour utilisateur. Sans ce journal, aucun indicateur du tableau ne se calcule et aucun incident ne s'explique. Il sert aussi à la conformité : les fiches pratiques IA de la CNIL demandent de pouvoir rendre compte des traitements, et le règlement européen sur l'IA impose la traçabilité aux systèmes à haut risque. La durée de conservation du journal et la minimisation des données personnelles qu'il contient se décident au cadrage, pas après le premier incident.
Versionner ce qui change réellement
Dans une application LLM, ce qui change n'est pas seulement le code. Quatre objets doivent être versionnés, et chaque version du journal doit dire lesquels étaient en service : le prompt système et les consignes, l'index documentaire (quels documents, découpés comment, avec quel modèle d'embedding), le modèle et sa version exacte chez le fournisseur, et la liste des outils exposés à l'agent avec leurs droits. Un incident se résout en comparant deux versions ; sans versionnage, il se résout en devinant. La règle qui vaut pour l'intégration d'un agent à un ERP, un journal de chaque appel avec ses paramètres, est la même ici.
Le cycle de correction, sans repartir de zéro
Un indicateur passe le seuil. Le journal montre les requêtes concernées. Le cas est ajouté au jeu de test. La correction, réindexation, ajustement du prompt, changement de modèle pour une tâche, est testée sur le jeu complet, pas seulement sur le cas nouveau, pour vérifier qu'elle ne casse rien. Elle est déployée avec un numéro de version, et le score de la semaine suivante confirme. Ce cycle prend une demi-journée quand le jeu de test et le journal existent, et plusieurs jours de tâtonnement quand ils n'existent pas.
Ce qui rend une application LLM ingérable
Ne pas rejouer le jeu de test après la mise en production, ce qui fait découvrir la dégradation par les utilisateurs. Laisser le nom de modèle sans version dans la configuration, ce qui fait changer le comportement le jour où le fournisseur met à jour. Et ne pas mesurer le coût par client, ce qui fait découvrir sur la facture qu'un seul usage a consommé le budget du mois.
Le premier mois après la livraison, chez JUWA
Chaque application livrée par JUWA part avec son jeu de test, son journal, ses versions et ses seuils d'alerte, définis au cadrage comme critères de succès. La mise en production IA comprend le rejeu hebdomadaire du jeu de test le premier mois, la lecture des transferts et des retours, et un point à un mois avec le seul chiffre qui compte pour le métier. Ensuite, l'entreprise reprend la main avec la documentation, ou confie le suivi à JUWA dans le cadre de la maintenance applicative d'une application IA.