Revenir sur les cas clients
Automatisation documentaire IAOCR intelligent sur mesurePME industrielle aéronautique

PME aéronautique : 317 h récupérées par mois

Mission livrée··mis à jour

  • 1 900documents vérifiés chaque mois
  • 317 hrécupérées par mois pour l'équipe ADV
  • 95 %taux de détection des anomalies
  • 15 sem.du cadrage à la mise en production
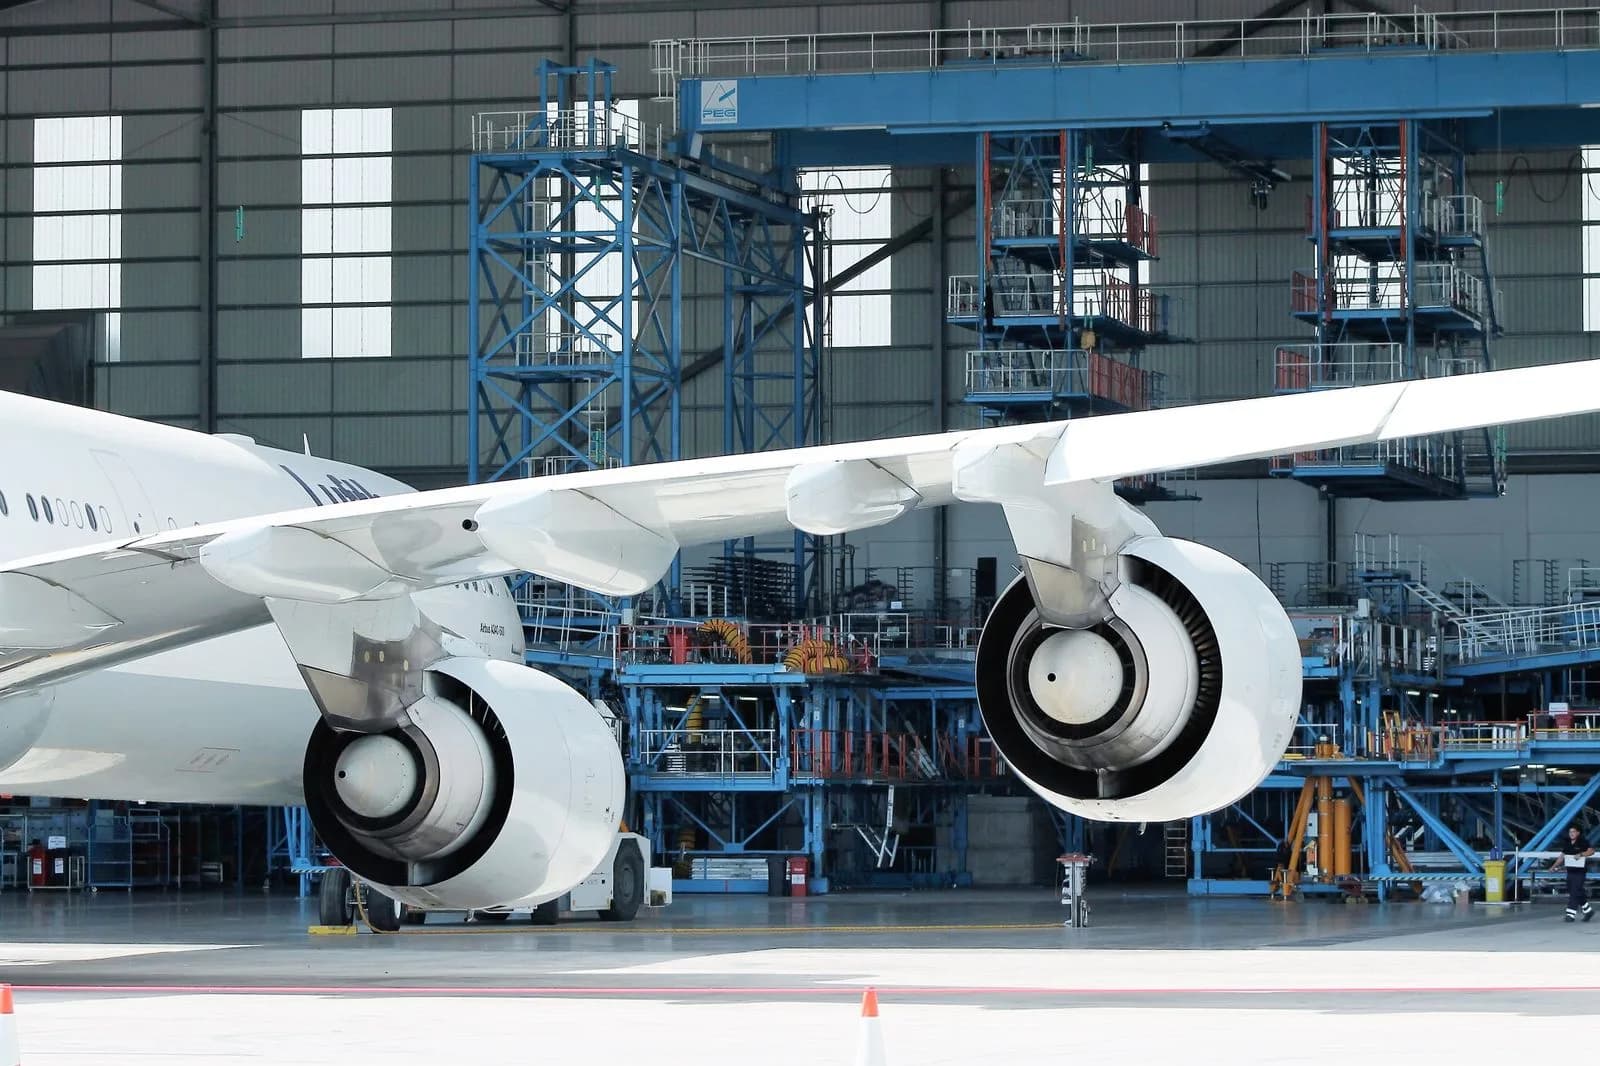
Avion en maintenance dans un hangar aéronautique, moteurs et aile au premier plan
Client
PME industrielle aéronautique, filiale d'un groupe international
Secteur
Composants techniques pour l'aéronautique et le ferroviaire
Périmètre
Vérification automatisée de 1 900 bons de commande et accusés par mois
Volume documentaire
Près de 9 500 pages lues chaque mois, 90 % des commandes en PDF
Équipe
7 opératrices ADV et un chef de projet IT mobilisés côté client
Intégration
Export quotidien de la base miroir de l'ERP, en lecture seule
Durée
15 semaines, du cadrage opérationnel à la mise en production
L'essentiel
Une PME industrielle aéronautique, filiale d'un groupe international, comparait à la main chaque bon de commande à son accusé de réception, pour plus de 3 000 clients actifs. Sept opératrices ADV y passaient 475 heures par mois. JUWA a développé un outil de comparaison OCR et IA hébergé en cloud souverain européen, calé sur les formats documentaires du client. Il leur en rend 317.

Industrialiser une vérification documentaire critique sans la confier à une boîte noire

Le défi posé par le client : industrialiser une vérification documentaire à haute criticité sans la déléguer à une boîte noire, et sans ajouter la moindre dépendance à un cloud non souverain.

475 heures par mois à comparer des PDF à la main

Notre client est une PME industrielle française, filiale d'un groupe international, spécialisée dans la fabrication de composants techniques pour les secteurs aéronautique et ferroviaire. Avec plus de 3 000 clients actifs, des grands donneurs d'ordre de l'aéro aux opérateurs ferroviaires, l'entreprise traite un volume considérable de commandes chaque mois. Le service Administration des Ventes, composé de sept personnes, réceptionne les bons de commande par email, les saisit manuellement dans l'ERP, puis génère un accusé de réception pour chaque commande. Jusque-là, rien d'anormal. Le problème, c'est l'étape d'après : chaque accusé doit être comparé au bon de commande d'origine pour vérifier que la saisie est correcte. Références produits, quantités, prix unitaires, unités de vente, délais de livraison, tout doit correspondre. Et quand 3 000 clients arrivent chacun avec ses codes articles, son format de commande et ses conditions propres, la vérification d'une seule paire de documents prend jusqu'à quinze minutes. Neuf bons de commande sur dix arrivent en PDF, dans la mise en page propre à chaque donneur d'ordre, sans aucune structure exploitable par une machine. Le reste arrive dans des formats encore moins réguliers. À raison de trois à quatre pages par commande et d'une à deux par accusé, l'équipe lit près de 9 500 pages chaque mois. Et malgré ce temps passé, une dizaine de non-conformités passent au travers tous les mois, soit 0,53 % des accusés envoyés.
Opératrice comparant un dossier papier aux données affichées sur son écran
Sept personnes à l'administration des ventes, jusqu'à quinze minutes par paire de documents, 1 900 paires chaque mois.

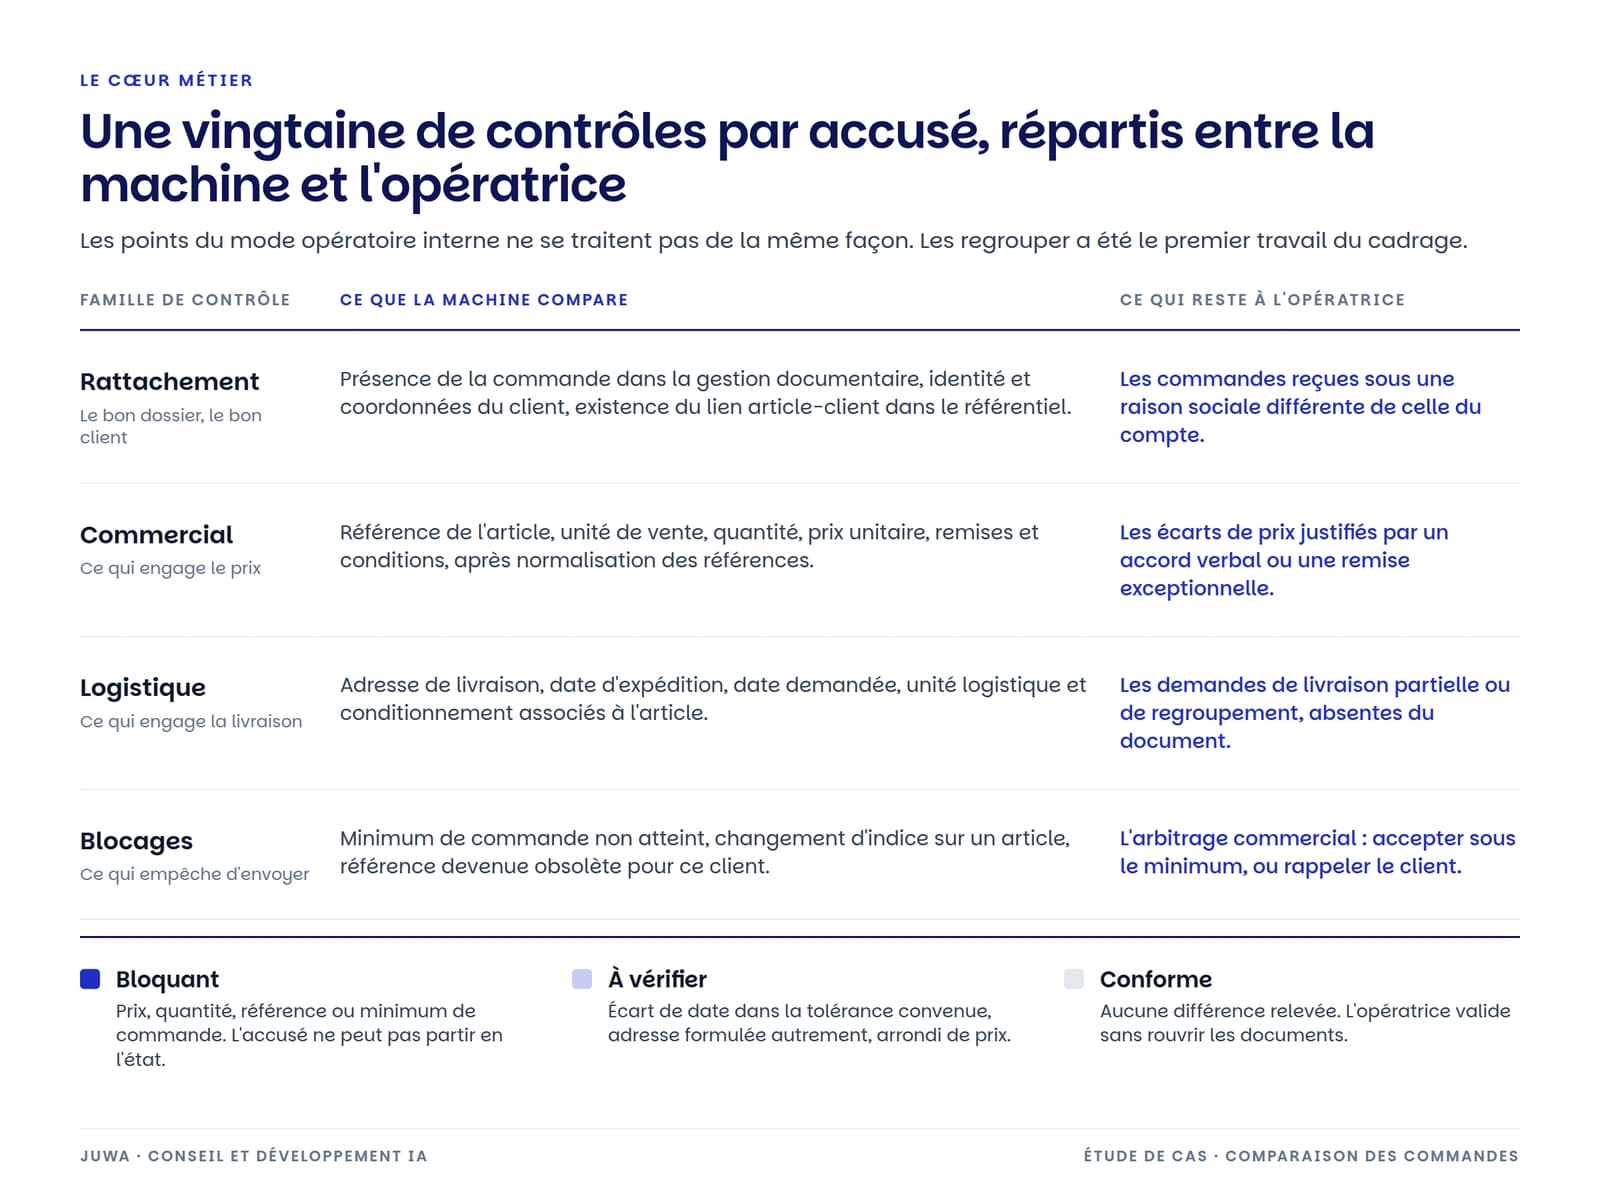
Une vingtaine de contrôles par accusé, et tous n'appellent pas la même réponse

Le mode opératoire interne du client décrit une vingtaine de points à vérifier sur chaque accusé. Les regrouper a été le premier travail du cadrage, parce qu'ils ne se traitent pas de la même façon. Le rattachement d'abord : la commande est-elle bien présente dans la gestion documentaire, le client est-il le bon, la référence de l'article existe-t-elle pour ce compte. Le commercial ensuite, tout ce qui engage le prix : référence, unité de vente, quantité, prix unitaire, remises et conditions. La logistique enfin : adresse de livraison, date d'expédition, date de livraison demandée, unité logistique et conditionnement associés à l'article. Une quatrième famille échappe à la comparaison pure, celle des blocages. Minimum de commande non atteint, changement d'indice sur un article, référence devenue obsolète pour ce client. Le système les détecte et les signale, mais la décision revient au commercial : accepter sous le minimum ou rappeler le client ne se déduit d'aucune règle. Les écarts remontent sur trois niveaux. Bloquant quand le prix, la quantité, la référence ou le minimum de commande divergent, et l'accusé ne peut pas partir en l'état. À vérifier quand l'écart reste dans la tolérance convenue, un arrondi de prix ou une adresse formulée autrement. Conforme quand rien ne diverge, et l'opératrice valide sans rouvrir les documents. L'essentiel du développement n'a pas porté sur la lecture des documents mais sur la normalisation. Une même référence s'écrit de plusieurs façons selon le donneur d'ordre, une quantité s'exprime en unité de vente ici et en unité logistique là. Sans ce travail de mise à plat, l'outil signale des écarts qui n'en sont pas, et l'opératrice cesse de lui faire confiance.
Tableau des quatre familles de contrôle et de la répartition entre la machine et l'opératrice
Ce que la machine compare, ce qui reste à l'opératrice, et les trois niveaux de signalement.

Deux PDF déposés, un tableau d'écarts en vert et rouge

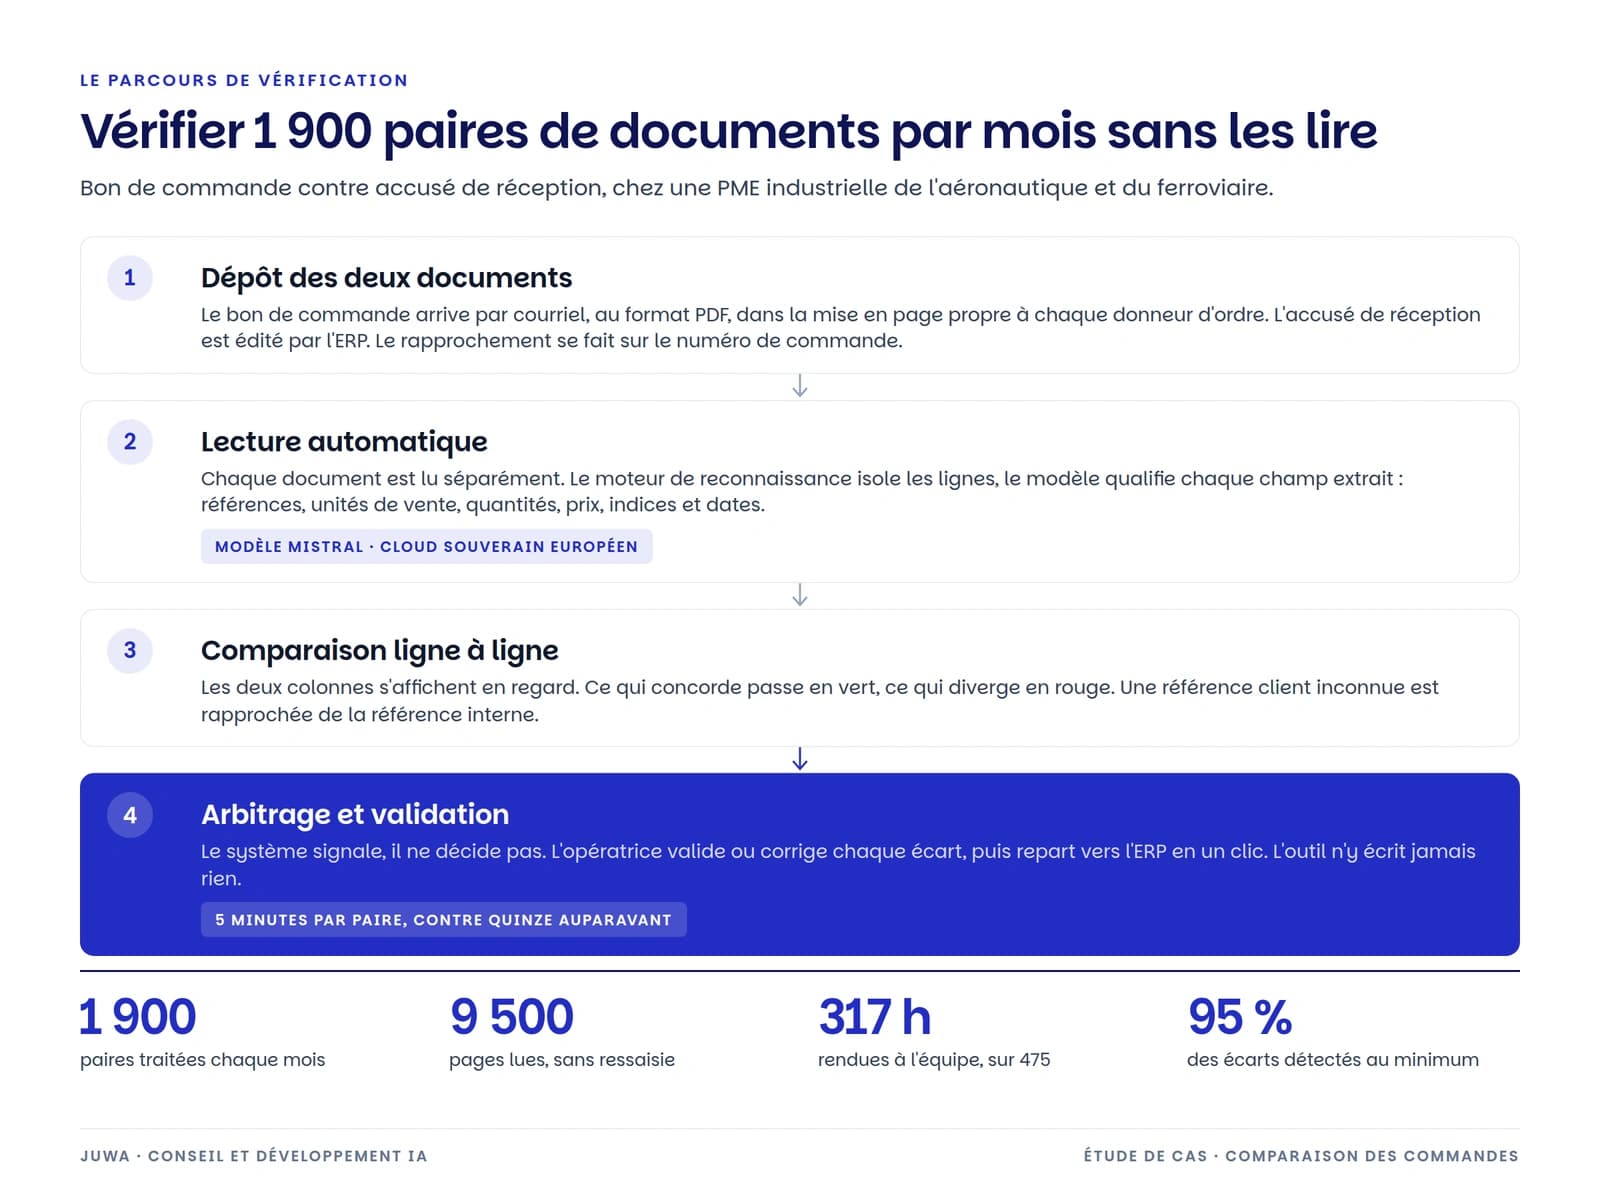
Plutôt qu'une solution clé en main du marché, dont les trois options évaluées en amont ne couvraient pas le besoin d'interface visuelle exprimé par le client, JUWA a conçu un outil sur mesure. L'opératrice dépose ses deux documents, bon de commande et accusé de réception. Le moteur OCR couplé à un modèle IA souverain extrait les données de chacun, puis un tableau de comparaison s'affiche au centre de l'écran, les deux colonnes en regard. Ce qui concorde passe en vert, ce qui diverge en rouge. Quand une référence client ne correspond à aucune référence interne, le système interroge la base de données produits pour tenter un rapprochement automatique. Le rapprochement des deux documents se fait sur le numéro de commande. Quand ce numéro est absent du document du client, mal imprimé ou illisible, la paire part dans une file d'attente de rapprochement plutôt que d'être comparée à tort : un faux écart coûte plus cher qu'une comparaison différée. L'interface a été développée en React et Next.js, avec un back-end connecté à la base de données miroir du client. Le modèle d'extraction tourne sur Mistral, hébergé en cloud souverain européen. Chaque comparaison et chaque validation sont horodatées dans un journal dédié, pour répondre aux exigences de traçabilité du secteur.
Schéma du parcours de vérification en quatre étapes : dépôt, lecture automatique, comparaison ligne à ligne, arbitrage
L'humain ne saisit plus, il arbitre. La validation reste à l'opératrice à chaque étape

Ce que nous avons décidé de ne pas faire

Une semaine de cadrage sert autant à tracer les limites qu'à définir le périmètre. Quatre décisions ont été prises avant la première ligne de code, et chacune a réduit le risque du projet. L'outil n'écrit jamais dans l'ERP. Une écriture erronée se propagerait à la facturation et à la livraison, pour un gain de quelques secondes. La correction se fait donc dans l'ERP, par l'opératrice, avec un export tableur des écarts et un retour à l'ERP en un clic depuis l'écran de comparaison. Aucun accusé n'est validé automatiquement, pas même ceux que le système déclare conformes. L'opératrice reste responsable de ce qui part chez le client. C'était une exigence métier, pas une limite technique. L'intégration passe par un export quotidien de la base miroir plutôt que par une connexion applicative directe à l'ERP. La fraîcheur quotidienne suffisait au besoin, et cette voie a fait gagner plusieurs semaines de développement. La connexion directe reste ouverte le jour où le volume l'exigera. Enfin, l'outil traite les documents rédigés en français. La totalité du volume du site l'est, et les autres langues seront chiffrées à part si le groupe étend la solution à ses entités étrangères.

Une semaine de cadrage, douze de sprints, deux d'essai terrain

L'obstacle principal n'était pas technique. Sept opératrices ADV travaillaient depuis des années avec leur checklist papier et plusieurs fenêtres ERP ouvertes en parallèle. Il fallait qu'elles adoptent un outil neuf sans rien perdre en rigueur ni en confiance. JUWA a commencé par une semaine de cadrage opérationnel : passation avec le cabinet d'accompagnement qui avait réalisé le diagnostic IA initial, entretiens avec les opératrices et le chef de projet IT, validation des règles métier critiques, de la gestion des blocages aux correspondances entre références client et internes, jusqu'au cas des commandes multi-lignes. Cette immersion a permis de maquetter une première version de l'interface avant d'écrire la moindre ligne de code. Trois conditions avaient été posées au client avant le démarrage, et chacune conditionnait une phase : un accès en lecture à la base miroir avec un compte dédié, une centaine de bons de commande et autant d'accusés réels pour régler puis éprouver le moteur, et la disponibilité d'une opératrice chaque semaine. Un mode opératoire écrit ne dit jamais tout de la pratique réelle. Le développement a duré douze semaines en sprints, avec un point hebdomadaire réunissant le chef de projet client, le DSI groupe et l'équipe JUWA. Chaque livraison intermédiaire était testée sur des jeux de données réels, pas sur des cas de laboratoire. La recette finale a mobilisé deux opératrices en bêta pendant deux semaines, avec remontée directe des ajustements nécessaires. Deux critères d'acceptation avaient été écrits au cadrage : plus de 95 % des écarts détectés, et aucun écart bloquant manqué.
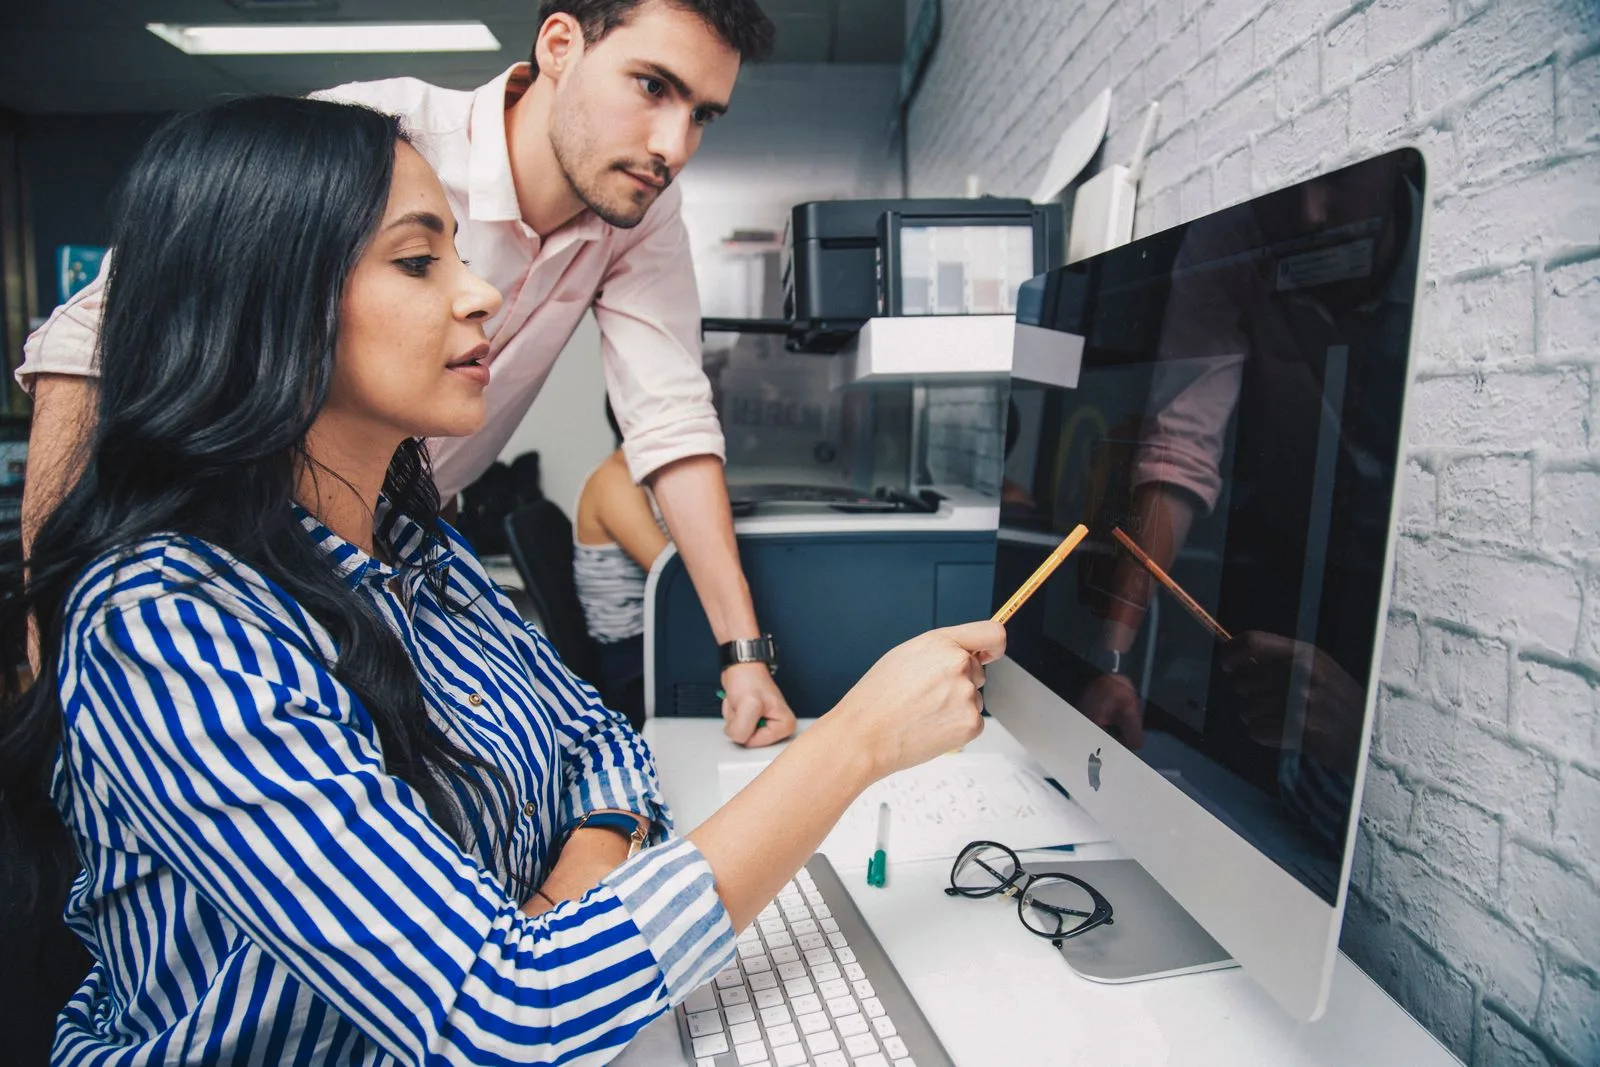
Deux collègues examinant ensemble un écran d'ordinateur, l'une pointant un détail à l'écran
Deux opératrices en bêta pendant deux semaines, sur des jeux de données réels et non des cas de laboratoire.

Ce que 317 heures par mois changent pour une équipe de sept

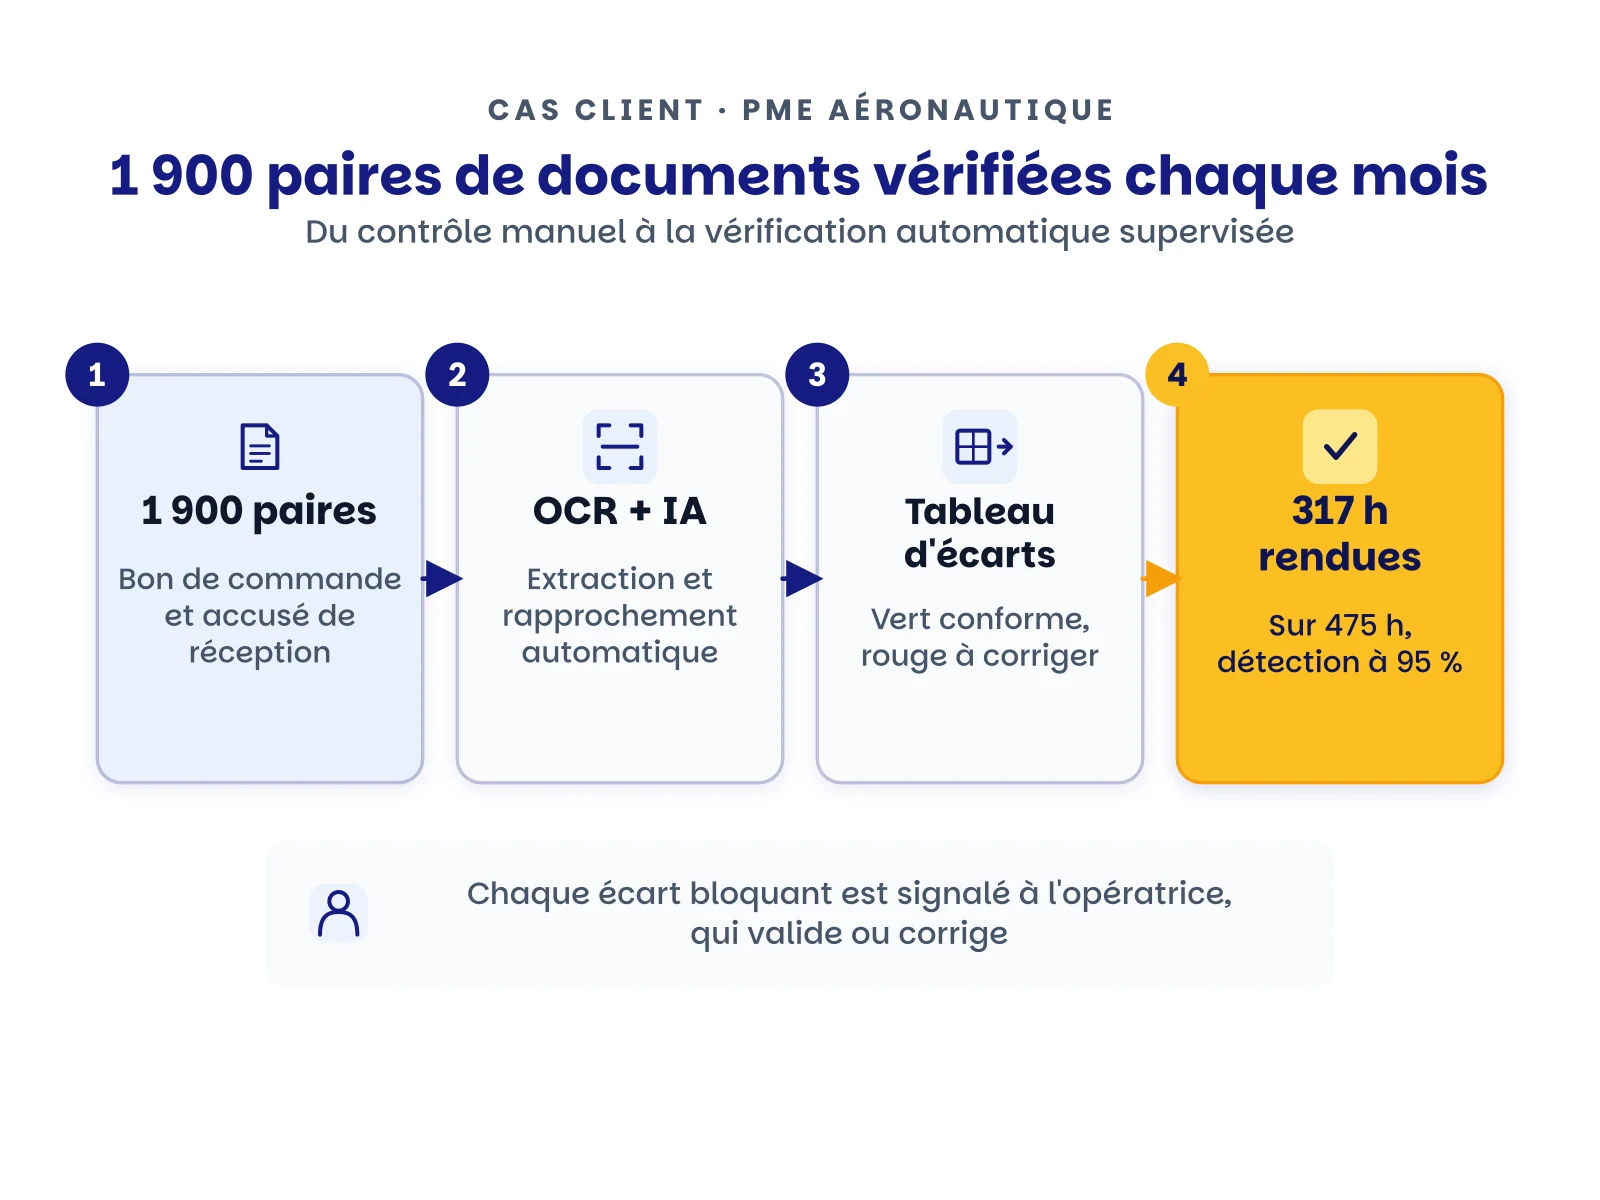
Le temps de traitement d'une paire de documents est passé de quinze minutes à cinq au maximum. Sur 1 900 paires par mois, l'équipe ADV récupère 317 des 475 heures qu'elle y consacrait. Les 158 heures restantes sont celles de l'arbitrage, quand le tableau signale un écart et que l'opératrice tranche. Le taux de détection des anomalies se maintient au-delà de 95 %. Le nombre de non-conformités n'a pas augmenté : c'était la contrainte posée au cadrage, gagner du temps en perdant en qualité aurait été un échec. Aucune validation n'a été retirée à l'humain. Le système signale, il ne décide pas : c'est la condition posée par le client dès le premier entretien, et elle a structuré toute l'architecture. L'outil a été livré avec sa documentation technique, un export CSV des corrections et trois mois de support dédié. L'architecture a été pensée duplicable sur les autres entités du groupe, sans dépendance à un cloud non souverain.
Schéma du flux de vérification documentaire : 1 900 paires de bons de commande et d'accusés de réception traitées chaque mois par l'OCR et l'IA de rapprochement, un tableau d'écarts vert et rouge, et 317 heures rendues chaque mois à l'équipe ADV.
1 900 paires de documents par mois, un tableau d'écarts, et 317 heures rendues à l'équipe ADV.

Cap de la mission

Objectifs de la mission

  1. Réduire le temps de vérification par paire de documents de 15 à 5 minutes maximum, pour un gain mensuel cible de 317 heures.

  2. Maintenir un taux de détection des anomalies supérieur à 95 % sans dégrader la qualité existante.

  3. Construire une interface de comparaison visuelle, documents côte à côte, avec tableau central des écarts et validation en un clic.

  4. Laisser la décision finale à l'opératrice sur chaque accusé, y compris ceux déclarés conformes par le système.

  5. Concevoir une architecture duplicable sur les autres entités du groupe, sans dépendance à un cloud non souverain.

Ce que le client garde en propre

À la fin de la mission, le code sur mesure et les modèles d'extraction sont cédés au client, sans restriction d'usage. La documentation technique décrit l'architecture, les flux applicatifs et les choix retenus, avec la description de l'interface applicative au format OpenAPI. Les équipes ont été formées et disposent d'un guide d'utilisation illustré, couvrant les cas courants et les procédures de dépannage. Un référent technique est resté disponible trois mois, une heure par semaine, avec un canal de questions ouvert en continu entre deux points. L'export complet des données reste possible à tout moment, en JSON, CSV ou SQL, sans frais et sans délai. C'est ce qui rend l'architecture réellement duplicable sur les autres entités du groupe, sans que le client ait besoin de nous pour le faire.

Un enjeu proche du vôtre ?

Parlons de votre contexte et voyons ce qu'une mission similaire pourrait débloquer chez vous.

Prendre rendez-vous

Résultats mesurés

Des performances à la hauteur des attentes.

  • 1 900documents vérifiés chaque mois
  • 317 hrécupérées par mois pour l'équipe ADV
  • 95 %taux de détection des anomalies
  • 15 sem.du cadrage à la mise en production

Simulateur

Combien vous coûte la vérification manuelle ?

90 / jour
15 min
28 € / h
Économie par an

91 476 €

Coût annuel actuel

138 600 €

Coût avec l'IA

47 124 €

Heures libérées / mois

272 h

Méthode et hypothèses · 66 % du temps économisé

Estimez ce que votre équipe passe à comparer deux documents à la main, et ce qu'une automatisation OCR et IA lui rendrait. Les valeurs par défaut sont celles de cette mission.

Hypothèse : 66 % du temps de production économisé, gain constaté sur cette mission.

Estimation indicative fondée sur le gain de 66 % constaté sur cette mission. Le coût horaire par défaut est une hypothèse, à ajuster à votre grille salariale.

« On voulait garder la main sur la vérification, pas la déléguer à une boîte noire. L'outil qu'on a aujourd'hui fait exactement ça : il nous montre les écarts, il nous aide à aller vite, mais c'est toujours nous qui validons. Et surtout, on a récupéré du temps pour des tâches qui comptent vraiment. »

Responsable Administration des Ventes, PME industrielle aéronautique (mission confidentielle)

Zoom sur le consultant JUWA responsable du projet

Tristan Dumas

Consultant senior IA & automatisation, JUWA

Consultant senior IA et automatisation chez JUWA, Tristan Dumas pilote les missions de développement de solutions sur mesure pour les PME et ETI industrielles. Spécialiste de l'intégration IA dans des environnements techniques contraints, ERP sans API, bases de données héritées, exigences de souveraineté, il intervient du cadrage fonctionnel à la mise en production. Il traduit un besoin métier complexe en livrable opérationnel sans jamais sortir les équipes terrain de la boucle. Un outil que les opératrices n'utilisent pas est un outil raté, quelle que soit la qualité du modèle derrière.

Tristan Dumas
Questions fréquentes

Ce qu'il faut savoir sur cette mission.

Les trois solutions du marché évaluées en amont ne couvraient pas le besoin d'interface visuelle exprimé par le client : comparaison bon de commande / accusé de réception côte à côte, avec tableau d'écarts central et code couleur. JUWA a conçu un outil sur mesure en React/Next.js répondant exactement à ce besoin.

317 heures récupérées par mois sur 475 heures initialement consacrées à la vérification manuelle, soit un temps par paire de documents ramené de 15 à 5 minutes maximum, pour 1 900 documents traités chaque mois.

Taux de détection des anomalies supérieur à 95 %, validation humaine conservée à chaque étape (l'opératrice valide ou corrige les écarts détectés), rapprochement automatique des références client vs internes via la base de données produits. Deux critères d'acceptation avaient été écrits au cadrage : plus de 95 % des écarts détectés et aucun écart bloquant manqué.

Non, et c'est une décision de cadrage. Une écriture erronée se propagerait à la facturation et à la livraison. L'outil produit un export tableur des corrections et un bouton de retour à l'ERP en un clic depuis l'écran de comparaison ; la correction est faite par l'opératrice, dans l'ERP.

Quatre choses : l'écriture directe dans l'ERP, la validation automatique des accusés conformes, la connexion applicative directe à l'ERP (remplacée par un export quotidien de la base miroir, plus rapide à mettre en place) et le traitement des documents rédigés en anglais ou en chinois, la totalité du volume du site étant en français.

La paire de documents part dans une file d'attente de rapprochement au lieu d'être comparée à tort. Un faux écart coûte plus cher à la confiance de l'équipe qu'une comparaison différée de quelques minutes.

Oui. Le modèle d'extraction tourne sur Mistral hébergé en cloud souverain européen, sans dépendance à un service non-UE. Aucune donnée client ne sert à entraîner un modèle tiers. Chaque comparaison et chaque validation sont horodatées dans un journal dédié.

Le code sur mesure et les modèles d'extraction lui sont cédés sans restriction d'usage, avec la documentation technique (architecture, flux applicatifs, interface applicative décrite au format OpenAPI), la formation des équipes, un guide d'utilisation illustré et trois mois de support dédié. L'export complet des données reste possible à tout moment en JSON, CSV ou SQL.
Heineken
BlaBlaCar
DataBird
HelloSafe

Vos prochaines solutions IA intégrées dès demain