Indexer des plans techniques dans un RAG industriel demande quatre opérations que l'indexation de documents bureautiques ne demande pas : extraire le cartouche et les nomenclatures comme des données, découper la page en zones qui gardent leur sens, rattacher chaque segment à sa révision, et filtrer les versions périmées à la recherche. Sans ces quatre étapes, l'assistant répond avec assurance à partir d'un plan obsolète, ce qui est pire qu'aucune réponse. Chaque étape est détaillée ici, avec ce qu'elle a donné chez une PME industrielle où le temps de recherche du SAV a baissé de 55 %.
Pourquoi un plan n'est pas un document comme les autres
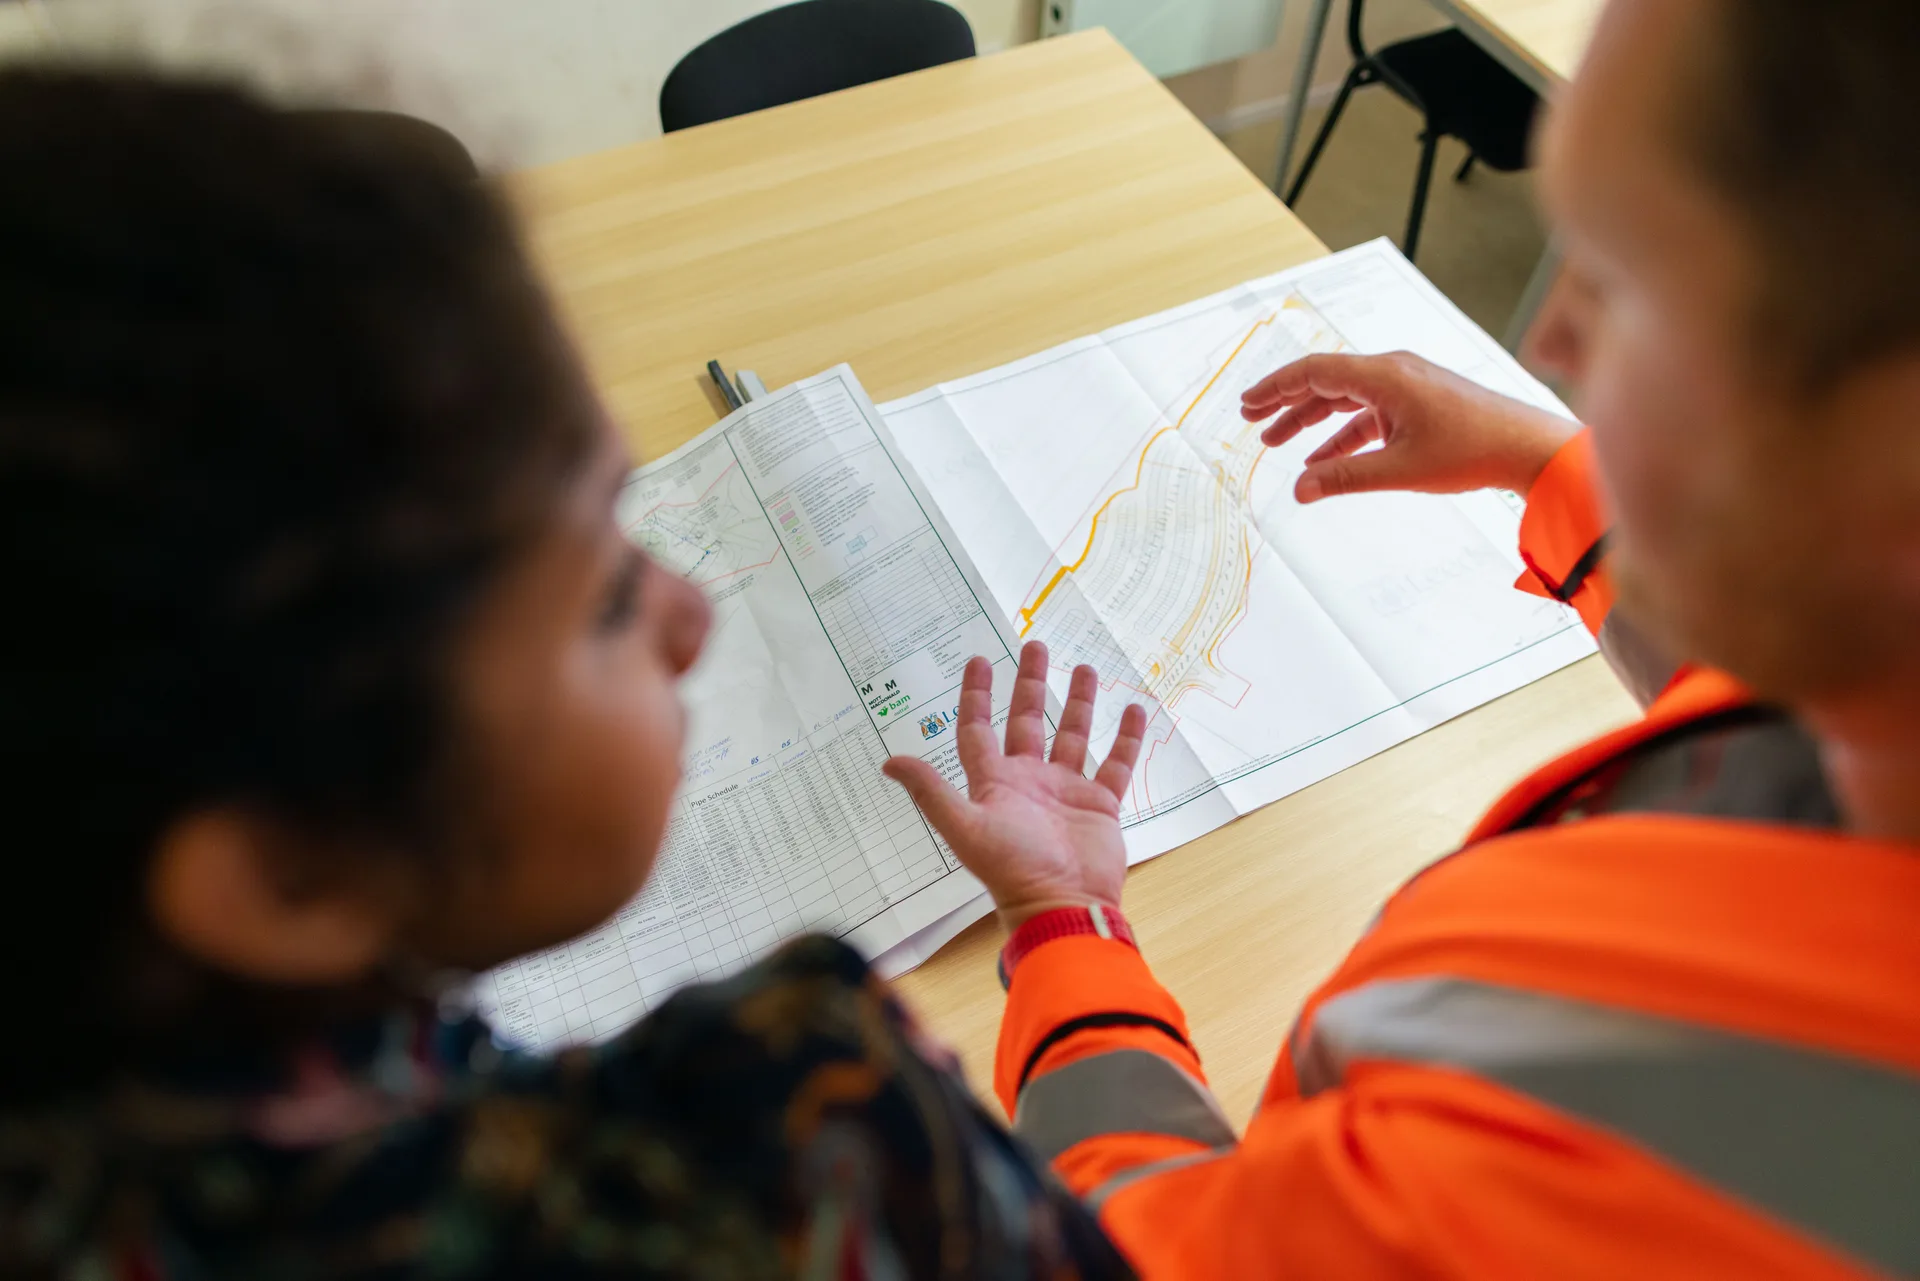
Un RAG classique découpe un texte en passages, calcule un vecteur par passage et retrouve les passages proches d'une question pour les donner au modèle, selon l'architecture décrite par Lewis et al. (2020). Un plan technique casse ce schéma. Le texte y est rare et dispersé : un cartouche avec le numéro de plan, l'indice de révision, la date et le dessinateur ; des cotes attachées à des traits ; une nomenclature en tableau ; des renvois vers d'autres plans. Lu comme un texte linéaire, le plan devient une suite de nombres sans contexte.
Le benchmark OmniDocBench confirme que les tableaux complexes et les mises en page non linéaires restent les cas où les outils d'analyse de PDF se trompent le plus. Ce sont exactement les deux composantes d'un plan. La préparation doit donc être pensée pour ce format, pas héritée d'un projet sur des notices.
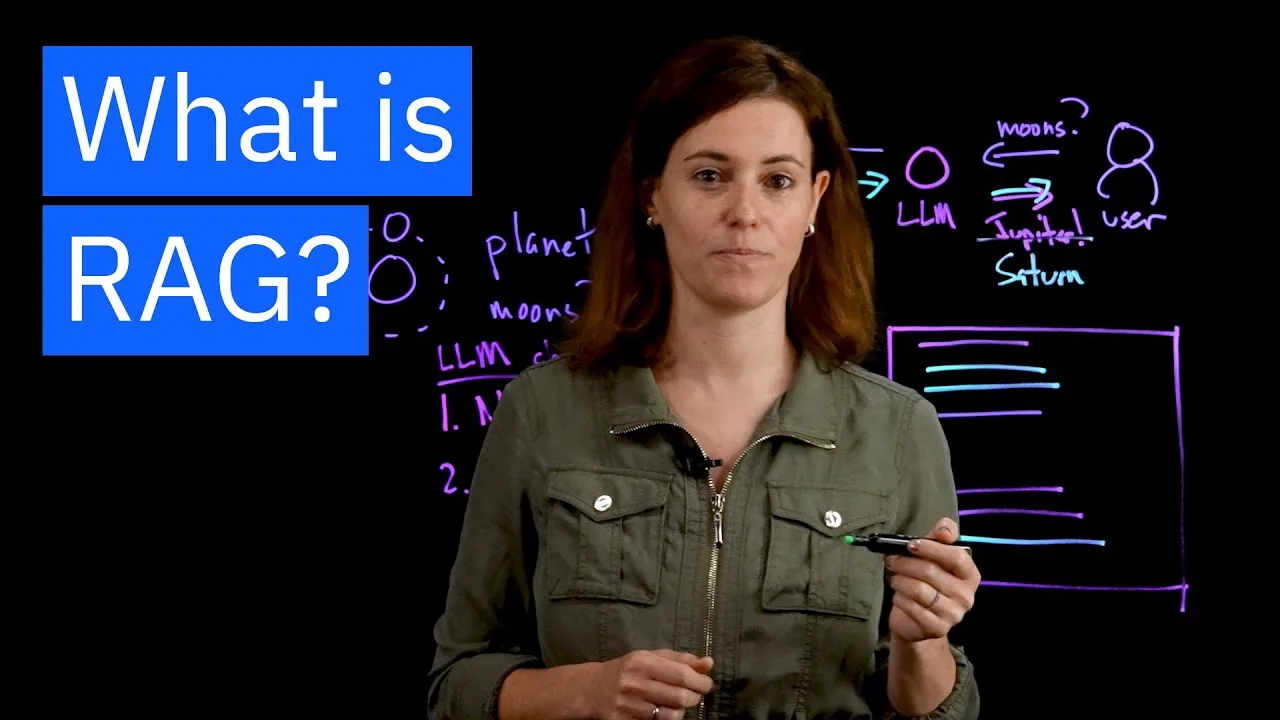
Résumé de la vidéo (7 min, en anglais) : IBM Technology explique le mécanisme du RAG, pourquoi il réduit les réponses inventées et pourquoi la qualité dépend d'abord de ce qui est indexé.
Étape 1 : extraire le cartouche et la nomenclature comme des données
Le cartouche est la carte d'identité du plan. Numéro, indice, date, projet, ensemble, auteur : ces champs doivent être extraits en données structurées et non noyés dans le texte, car ce sont eux qui serviront de filtres. Un modèle multimodal, comme l'API Document AI de Mistral, lit un cartouche à position variable là où un OCR à gabarit fixe échoue dès que le format de la feuille change.
La nomenclature (repère, désignation, quantité, matière, référence fournisseur) se traite comme un tableau : chaque ligne devient un enregistrement lié au numéro de plan. C'est ce qui permet ensuite de répondre à « quelle référence pour le repère 12 de l'ensemble X », une question qu'aucun découpage textuel ne sait servir. Le guide sur l'préparation d'une base documentaire pour un RAG couvre le socle commun ; cette étape en est la spécialisation pour les plans.
Étape 2 : découper par zones, pas par nombre de caractères
Le découpage à taille fixe (500 caractères, puis les 500 suivants) coupe une nomenclature au milieu d'une ligne et sépare une cote de la pièce qu'elle décrit. Pour un plan, le segment naturel est la zone : cartouche, nomenclature, chaque vue, chaque note de fabrication. Chaque zone devient un segment, préfixé par le numéro et l'indice du plan et par le type de zone (« Note de fabrication, plan 4521-B »), afin que le modèle sache d'où vient ce qu'il lit.
La structure parent-enfant complète ce découpage : on retrouve un segment fin (la note), et on fournit au modèle le contexte du parent (la vue, ou une synthèse du plan entier). C'est ce qui évite qu'une tolérance soit citée sans la pièce et le procédé auxquels elle s'applique.
Étape 3 : rattacher chaque segment à sa révision
C'est l'étape qui distingue un RAG industriel sûr d'un RAG dangereux. Deux indices d'un même plan coexistent presque toujours dans l'archive : l'ancien, encore référencé par des commandes en cours, et le nouveau. Si les deux sont indexés sans distinction, l'assistant cite l'un ou l'autre selon la formulation de la question. Chaque segment porte donc l'indice et la date de révision en métadonnée, et le statut du plan (en vigueur, remplacé, annulé) est synchronisé depuis la GED ou le PLM à chaque mise à jour.
Le contrôle se fait à la recherche : par défaut, seuls les segments en vigueur sont retournés ; l'historique reste accessible sur demande explicite (« que disait l'indice A »), avec la mention du statut dans la réponse. Une réponse qui cite une cote doit toujours indiquer le plan et l'indice d'où elle vient.
Étape 4 : mesurer avant d'ouvrir aux opérateurs
Un jeu de test de cinquante à cent questions réelles, avec la réponse attendue et le plan source, est écrit avec le bureau d'études et la maintenance avant l'ouverture. Il sert à mesurer la précision de la récupération (le bon segment est-il dans les résultats), la justesse des réponses et le taux de citations vers un plan périmé, qui doit être nul. Les métriques d'évaluation d'un RAG décrivent comment construire ce jeu et quoi mesurer ; sans lui, on ne sait pas si le découpage par zones a servi à quelque chose.
| Étape | Ce qu'on produit | Erreur évitée | Part de l'effort |
|---|---|---|---|
| Extraction du cartouche et de la nomenclature | Champs structurés par plan, une ligne par repère | Numéro de plan et références perdus dans le texte | 30 % |
| Découpage par zones | Un segment par zone, préfixé et rattaché à son parent | Cote séparée de sa pièce, nomenclature coupée | 25 % |
| Rattachement à la révision | Indice, date et statut en métadonnées, filtre par défaut | Réponse à partir d'un plan remplacé | 25 % |
| Jeu de test et mesure | 50 à 100 questions avec plan source | Ouverture sans preuve de fiabilité | 20 % |
Ce que ça a donné chez une PME industrielle
Une PME industrielle centenaire disposait de 2 000 documents techniques : notices, schémas, historiques de réparation, accumulés sur plusieurs décennies et plusieurs formats. JUWA les a préparés selon les quatre étapes ci-dessus et indexés dans un assistant documentaire hébergé en France. Le temps de recherche du SAV a baissé de 55 %. La part la plus longue du projet n'a pas été le modèle mais le tri : retirer les versions périmées et reconstituer, pour les documents les plus anciens, un cartouche qui n'existait que sur papier.
Le même besoin ressort dans un autre contexte industriel, l'audit IA d'un opérateur de consignes automatisées : 6 000 machines à maintenir, une documentation dispersée, et une feuille de route où l'accès des techniciens à la bonne version de la procédure figure parmi les premiers chantiers chiffrés. La Direction générale des Entreprises range d'ailleurs la recherche intelligente sur documentation technique parmi les cas d'usage IA les plus rentables pour une PME dans son guide France Num.
Les trois raccourcis qui coûtent cher
Indexer l'archive entière sans trier, parce que « le modèle fera le tri » : il ne le fait pas, il mélange. Découper avec le même outil que pour les contrats et les notices, sans traitement du cartouche : le numéro de plan disparaît, et avec lui toute possibilité de citer la source. Ouvrir l'assistant sans jeu de test, sur la foi d'une démonstration réussie sur trois questions : les opérateurs découvrent les réponses fausses en atelier, et ne reviennent plus.
La méthode JUWA sur un fonds de plans
Le cadrage part d'un échantillon de cinquante plans représentatifs, les plus anciens et les plus abîmés compris, et de la liste des questions que se posent réellement le SAV, la maintenance et le bureau d'études. JUWA mesure sur cet échantillon la qualité d'extraction du cartouche et de la nomenclature, fixe le découpage par zones, branche la synchronisation des statuts depuis la GED ou le PLM, puis construit le jeu de test avec les équipes. L'assistant n'est ouvert qu'une fois le taux de citation de plans périmés à zéro sur ce jeu. C'est la méthode appliquée à chaque projet IA en industrie accompagné par JUWA, de la documentation technique à la maintenance.