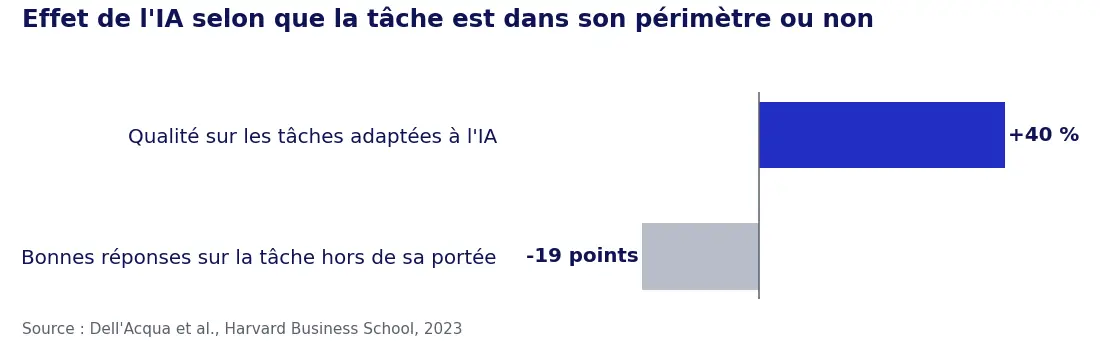
Les limites de l'IA générative ont été mesurées avec précision chez Boston Consulting Group en 2023. Sur les tâches adaptées, les consultants équipés de GPT-4 ont rendu un travail de qualité supérieure de plus de 40 % à celui de leurs collègues sans IA. Sur une tâche placée volontairement hors de portée de l'outil, ils ont eu 19 points de probabilité en moins de trouver la bonne réponse.
En 2023, personne ne connaissait les limites de l'IA générative
Lorsque GPT-4 arrive en entreprise, une question revient partout. Sur quelles tâches peut-on confier le travail à l'IA sans risque, et sur lesquelles faut-il s'en méfier ? Les démonstrations publiques montrent un outil capable de rédiger, de résumer et de proposer des idées en quelques secondes. Elles ne disent rien de ses erreurs.
Faute de réponse, les directions tranchent souvent à l'aveugle. Interdire l'outil par prudence ou l'ouvrir à tous sans consigne revient au même, puisque personne ne sait quelles tâches gagnent à être confiées à l'IA et lesquelles y perdent.
Pour un cabinet de conseil, l'enjeu est direct. Le métier consiste à produire des analyses, des recommandations et des documents sous forte contrainte de temps. Un outil qui accélère la production vaut beaucoup, à condition de ne pas dégrader la justesse du raisonnement, car c'est elle que le client paie. Une recommandation erronée remise à un comité de direction coûte bien plus cher que les heures gagnées à la rédiger.
C'est le point de départ de l'étude « Navigating the Jagged Technological Frontier », menée par des chercheurs de Harvard Business School, de Wharton et du MIT avec Boston Consulting Group. Parmi les auteurs figurent Fabrizio Dell'Acqua, Ethan Mollick, Karim Lakhani et François Candelon. Le travail a d'abord circulé comme document de travail, puis a été publié dans la revue Organization Science.
Le titre résume l'intuition des chercheurs. La frontière technologique de l'IA, c'est-à-dire la limite entre ce qu'elle fait bien et ce qu'elle fait mal, n'est pas une ligne droite. Elle est irrégulière, découpée en dents de scie, et deux tâches qui paraissent de difficulté comparable peuvent tomber de part et d'autre.
Une expérience randomisée avec 758 consultants de BCG
Les chercheurs ont retenu le dispositif d'un essai contrôlé. D'après le document de travail publié en septembre 2023, 758 consultants de BCG ont participé, soit environ 7 % des consultants juniors et intermédiaires du cabinet. Ils ont été répartis au hasard entre un groupe qui travaillait avec GPT-4 et un groupe témoin qui travaillait sans.
Le premier volet comprenait 18 tâches réalistes de conseil. Il fallait imaginer des idées de nouveaux produits, bâtir un plan de lancement, rédiger des textes destinés à des clients. Ce sont des travaux de création et de mise en forme, proches de ce qu'un consultant produit chaque semaine.
Venait ensuite un volet d'une autre nature. Les chercheurs ont conçu une tâche d'analyse que l'IA de l'époque ne savait pas résoudre correctement. L'objectif était d'observer ce qui se passe quand un professionnel s'appuie sur l'outil là où celui-ci ne sait pas faire.
Ce choix de méthode donne toute sa valeur à l'étude. Les mêmes profils, dans le même cabinet, ont été observés de part et d'autre de la frontière. On peut donc comparer l'effet de l'IA selon la nature de la tâche, à profils égaux.
Dans le périmètre de l'IA, plus de 40 % de qualité en plus
Sur les 18 tâches adaptées, les résultats sont nets. D'après les auteurs, les consultants équipés de GPT-4 ont réalisé 12,2 % de tâches en plus et les ont terminées 25,1 % plus vite. Leur travail a été jugé de qualité supérieure de plus de 40 % par rapport au groupe témoin.
L'effet n'est pas le même pour tout le monde. Les consultants les moins performants au départ ont progressé de 43 %, les plus performants de 17 %. L'outil resserre donc les écarts de niveau, un effet de rattrapage que nous avions déjà abordé avec l'étude sur le service client.
Hors de sa portée, l'IA fait baisser le taux de bonnes réponses de 19 points
Sur la tâche d'analyse conçue pour piéger l'outil, le résultat s'inverse. D'après l'étude, les consultants qui utilisaient GPT-4 avaient 19 points de probabilité en moins de trouver la bonne réponse que ceux qui travaillaient seuls. L'outil a fait se tromper des professionnels qui, sans lui, auraient eu plus de chances de voir juste.
L'hypothèse la plus simple tient à la forme des réponses. L'outil produit un texte soigné et cohérent en apparence, et l'utilisateur, rassuré, risque de le reprendre sans refaire le raisonnement. Les erreurs de l'IA sont d'autant plus dangereuses qu'elles ressemblent à du bon travail.
Ces deux résultats ensemble forment le vrai enseignement de l'étude. Le même outil, utilisé par les mêmes personnes, fait gagner beaucoup sur une tâche et fait perdre sur une autre. Rien, dans l'apparence de la tâche, ne signale à l'utilisateur de quel côté de la frontière il se trouve.
Centaures et cyborgs, deux façons de bien travailler avec l'IA
Les chercheurs ont observé la manière dont les consultants les plus efficaces s'y prenaient. Ils ont identifié deux comportements. Les « centaures » répartissent clairement le travail, en gardant pour eux certaines étapes et en confiant les autres à l'IA. Les « cyborgs » mêlent l'outil à chaque étape, en le relançant, en le corrigeant et en reprenant sa production phrase par phrase.
Ces deux approches ont un point commun. Le consultant y reste l'auteur du travail et décide lui-même de ce qu'il confie à l'outil, au lieu de lui déléguer le résultat en bloc.
Cette observation compte pour une entreprise qui prépare un déploiement. Former les équipes à se servir de l'outil ne suffit pas. Il faut aussi leur apprendre à reconnaître les tâches où il se trompe, et à garder dans ces cas une vérification systématique.
Dans une conférence au Stanford Digital Economy Lab, Ethan Mollick présente l'étude et ses résultats, avec le regard d'un des auteurs sur la façon dont les consultants ont utilisé l'outil.
Ce que l'étude menée chez BCG ne permet pas de conclure
Le niveau de preuve est élevé, puisqu'il s'agit d'une expérience randomisée sur un effectif important. Il faut pourtant lire ces chiffres avec leurs conditions. Les tâches ont été réalisées en conditions contrôlées, sur des cas préparés par les chercheurs. Le quotidien d'un cabinet, avec ses clients, ses données internes et ses allers-retours, est plus désordonné.
Autre réserve, le modèle testé est GPT-4 dans sa version de 2023. Les modèles ont progressé depuis, et la frontière s'est déplacée avec eux. Elle n'a pas disparu, et elle reste aussi irrégulière qu'avant.
Le chiffre de 40 % ne se transpose pas non plus tel quel à une autre entreprise. Il mesure la qualité obtenue sur des tâches de conseil précises. Un gain comparable sur la rédaction d'offres commerciales ou de rapports techniques reste à vérifier sur place, avec les documents réels et les personnes qui les produisent.
Enfin, l'étude porte sur des consultants, un métier très qualifié et habitué à l'écrit. Le résultat sur la frontière vaut pour tous les métiers. L'ampleur des gains, elle, dépend du poste.
Ce que ça change pour une PME ou une ETI
Pour une entreprise qui déploie l'IA générative, le principal risque n'est pas qu'elle ne serve à rien. C'est qu'elle soit utilisée avec la même confiance sur toutes les tâches, alors qu'elle n'est fiable que sur une partie d'entre elles. Les limites de l'IA générative ne s'annoncent pas, et chaque salarié les découvre seul, souvent trop tard.
Prenons un bureau d'études de 60 personnes dans le bâtiment. Confier à l'IA la mise en forme d'un mémoire technique, la synthèse d'un compte rendu de chantier ou la première version d'un courrier fait gagner du temps sans grand danger. Lui demander de vérifier la conformité d'une note de calcul, ou d'arbitrer entre deux lectures d'un cahier des clauses techniques, relève d'une autre catégorie. La réponse sera bien écrite. Elle pourra être fausse.
Un cabinet d'expertise comptable rencontre la même situation. Rédiger une lettre de mission, reformuler une note fiscale pour un client ou préparer un ordre du jour se prête bien à l'outil. Interpréter un écart dans une balance ou trancher un point de doctrine demande un contrôle humain complet, parce qu'une erreur plausible y passe facilement inaperçue.
La bonne démarche consiste à cartographier la frontière tâche par tâche avant de généraliser l'usage. On liste les tâches du service, on teste l'outil sur des cas réels dont on connaît la bonne réponse, et on classe chaque tâche. Certaines sont confiées largement, d'autres assistées avec une relecture obligatoire, d'autres encore laissées hors du périmètre de l'IA.
Cette cartographie se révise régulièrement. Les modèles évoluent vite, et une tâche classée hors de portée il y a un an mérite d'être testée de nouveau. L'inverse arrive aussi, quand un nouvel usage apparaît dans un service sans que personne n'ait vérifié la fiabilité de l'outil sur ce terrain.
C'est le travail que nous menons en mission de conseil et audit IA, et que nous décrivons dans la méthode d'audit IA en quatre semaines. Ce que nous observons en mission rejoint l'étude de BCG. Les équipes surestiment l'outil sur l'analyse et le sous-estiment sur la rédaction et la reformulation.
Pour les sociétés de conseil, d'expertise ou d'ingénierie, dont le métier ressemble le plus à celui des consultants étudiés, nous avons construit une approche spécifique d'IA pour les cabinets de conseil. Elle part de leurs livrables réels et définit, pour chacun, ce que l'outil peut produire et ce qu'un professionnel doit valider.
Déployer un outil pour tous sans cette cartographie fait partie des erreurs à éviter pour lancer un projet d'IA. Une entreprise qui sait où passe la frontière peut viser les gains mesurés chez BCG. Celle qui l'ignore s'expose aussi à l'effet inverse, les 19 points de bonnes réponses en moins, sans s'en apercevoir.
Sources
- Navigating the Jagged Technological Frontier, Harvard Business School, document de travail, septembre 2023
- Navigating the Jagged Technological Frontier, Harvard AI Institute, 2023