Pour comprendre pourquoi les projets IA échouent, beaucoup de dirigeants partent d'un chiffre du MIT selon lequel 95 % des organisations ne tirent aucun retour de leurs projets d'IA générative. Le rapport, publié en juillet 2025 par le Project NANDA du MIT Media Lab, repose sur une méthode discutée. Sa conclusion porte pourtant moins sur la technologie que sur la façon dont les entreprises la déploient.
Trente à quarante milliards de dollars pour un retour rarement mesuré
Intitulé « The GenAI Divide, State of AI in Business 2025 », le rapport repose sur un matériau recueilli entre janvier et juin 2025. Les chercheurs ont passé en revue plus de 300 initiatives rendues publiques et mené 52 entretiens structurés. Ils y ajoutent 153 réponses de dirigeants à un questionnaire. Le compte rendu publié par Virtualization Review en août 2025 reprend l'essentiel de ces chiffres.
D'après les auteurs, les entreprises ont consacré entre 30 et 40 milliards de dollars à l'IA générative. Malgré ces montants, 95 % des organisations n'en tireraient aucun retour. La formule demande de la prudence, car elle repose sur ce que les entreprises ont pu déclarer et démontrer. Un outil utile mais jamais mesuré tombe du côté des 95 %, ce qui décrit un retour non démontré plutôt qu'un retour forcément nul.
L'écart entre l'usage et le résultat frappe davantage que le montant. Selon le MIT, plus de 80 % des organisations ont exploré ou testé des outils grand public comme ChatGPT ou Copilot, et près de 40 % les ont déployés. Les outils grand public sont donc entrés dans la plupart des organisations, sans que cette adoption se retrouve dans leurs comptes.
Pour un dirigeant, ne mesurer aucun retour revient à financer un outil sans savoir ce qu'il change. L'abonnement est payé, les équipes l'utilisent plus ou moins, et personne ne peut dire au bout d'un an si un délai a raccourci ou si une erreur a disparu. C'est cette zone grise que décrit l'étude du MIT sur les 95 %.
De l'évaluation à la production, un entonnoir qui se referme à 5 %
La déperdition est encore plus nette pour les solutions d'entreprise, conçues pour un métier ou un processus précis. Selon le rapport, 60 % des organisations en ont évalué, 20 % sont allées jusqu'au pilote et 5 % seulement jusqu'à la mise en production. La grande majorité des outils évalués ne dépasse donc jamais le stade de l'essai.
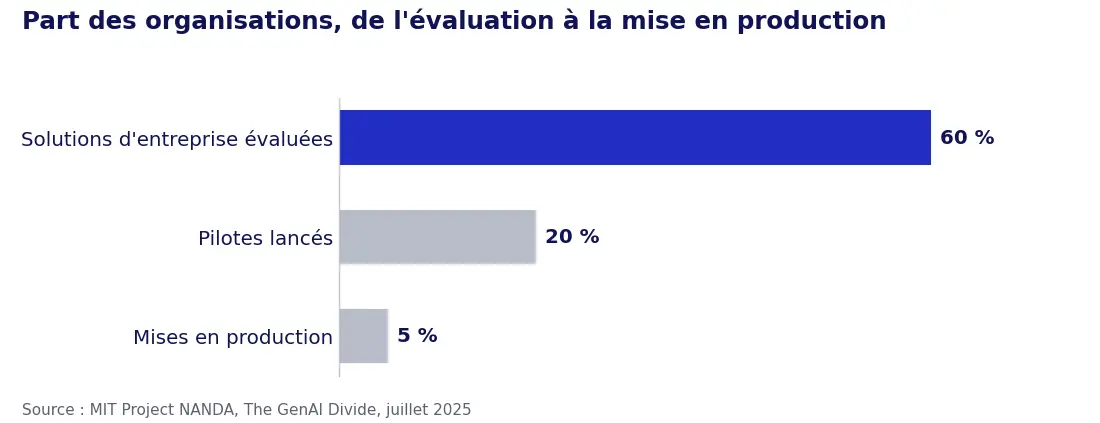
Le pilote concentre l'essentiel des abandons. Il s'agit d'un essai sur un périmètre restreint, avec quelques utilisateurs volontaires et souvent des données préparées pour l'occasion. Un pilote réussi prouve que l'outil fonctionne. Il ne prouve pas qu'il s'insère dans le travail réel, avec ses exceptions, ses urgences et les logiciels déjà en place.
La taille de l'entreprise pèse aussi sur la vitesse. D'après le MIT, les entreprises de taille moyenne passent du pilote à la production en 90 jours environ, contre 9 mois ou plus pour les grandes. Une structure plus courte décide plus vite et voit plus tôt si l'outil tient ses promesses sur le terrain.
Pourquoi les projets IA échouent selon les auteurs du MIT
Les auteurs écartent les explications habituelles. Ni la technologie, ni la réglementation, ni le manque de compétences ne constituent à leurs yeux l'obstacle principal. Ils désignent l'apprentissage, c'est-à-dire la capacité d'un outil à s'améliorer au contact de l'entreprise qui l'utilise.
Concrètement, les outils qui échouent ne retiennent pas les corrections de leurs utilisateurs. Ils ne s'adaptent pas au contexte, qu'il s'agisse du vocabulaire maison, des clients importants ou des règles implicites d'un service. Des mois plus tard, ils refont les erreurs du premier jour, et les équipes finissent par les contourner.
Ce diagnostic a une conséquence pratique. Un outil posé sur un processus mal compris reproduit ses défauts plus vite, sans les corriger. Quand personne n'a décrit comment une demande circule réellement, qui la valide et où elle bloque, l'IA automatise une version idéalisée du travail. Les salariés continuent de gérer la version réelle, à côté.
Prenons un assistant chargé de préparer les réponses aux appels d'offres. S'il ignore que tel client exige toujours une annexe technique, ou qu'une gamme a quitté le catalogue, chaque brouillon demande une relecture complète. Le gain espéré devient une tâche supplémentaire, et l'outil est abandonné sans que personne ne l'ait décidé officiellement.
À l'inverse, un outil qui apprend garde la trace des corrections apportées par ses utilisateurs et les réutilise sur les dossiers suivants. Il s'appuie sur les documents et les règles propres à l'entreprise plutôt que sur des connaissances générales. Ce travail d'adaptation se prépare avant le déploiement, en recensant les exceptions que les équipes gèrent sans y penser. Il se poursuit après, avec des retours réguliers des utilisateurs et quelqu'un chargé de les intégrer.
Des gains ressentis qui ne se retrouvent pas dans les mesures
Un deuxième mécanisme agit plus discrètement. Beaucoup d'entreprises pensent gagner du temps parce que leurs salariés ont le sentiment d'aller plus vite. L'étude METR sur les développeurs, publiée en juillet 2025, montre à quel point cette impression peut tromper.
L'organisme a mené une expérience randomisée avec 16 développeurs très expérimentés, sur 246 tâches réelles tirées de leurs propres projets open source (des logiciels dont le code est public). Chaque tâche était attribuée au hasard à une condition, avec ou sans IA. Les développeurs travaillaient avec Cursor, un éditeur de code doté d'un assistant, et les modèles Claude 3.5 ou 3.7 Sonnet.
Avec l'IA, ils ont mis 19 % de temps en plus pour terminer leurs tâches. Avant l'expérience, ils pensaient gagner 24 %. Une fois le travail fini, ils estimaient encore avoir gagné 20 %, alors que le chronomètre indiquait l'inverse.
Les auteurs précisent que ce résultat ne vaut pas pour tous les contextes. Il concerne des experts qui connaissent parfaitement leur propre code, et d'autres mesures aboutissent à des gains, comme le montre l'étude sur les assistants de code que nous avons analysée. Le décalage entre le ressenti et la mesure reste, lui, un avertissement pour toute organisation qui juge un outil à l'impression de ses utilisateurs.
Transposé à une entreprise, ce décalage éclaire une partie des 95 % du MIT. Sans mesure du temps de traitement d'un dossier avant l'arrivée de l'outil, rien ne pourra être affirmé après. Les utilisateurs diront qu'ils vont plus vite, et personne ne saura si c'est exact. Nous détaillons les indicateurs utiles pour mesurer le retour sur investissement d'un projet d'IA dans un article dédié.
Hors de son périmètre, l'IA dégrade la qualité du travail
Un troisième facteur tient au choix des tâches confiées à l'outil. Dans l'étude menée chez BCG, les consultants qui s'appuyaient sur l'IA pour une tâche située hors de son périmètre obtenaient 19 points de bonnes réponses en moins. Nous revenons sur les limites de l'IA mesurées chez BCG dans un autre article de cette série.
Le projet qui échoue n'a donc pas toujours un mauvais outil. Il a parfois un bon outil employé sur la mauvaise tâche, sans que personne n'ait tracé la frontière de sa zone de fiabilité. Le cas Klarna, analysé dans cette série, pose la même question à l'échelle d'un service client entier.
Une méthode discutée, qui appelle une lecture prudente
Plusieurs critiques visent le chiffre de 95 %, et certaines sont fondées. L'échantillon repose largement sur du déclaratif, qu'il s'agisse des entretiens ou des réponses au questionnaire. Une entreprise qui ne suit aucun indicateur tombe mécaniquement dans la catégorie sans retour mesuré, même si l'outil lui rend service.
La définition du retour sur investissement retenue par les auteurs est elle aussi discutée. Un projet qui fait gagner du temps sans effet visible sur le compte de résultat peut ainsi être classé parmi les échecs. Par ailleurs, 153 réponses à un questionnaire ne représentent pas l'ensemble des entreprises, et encore moins les PME françaises. Ces réserves n'ôtent pas son intérêt au rapport, mais elles interdisent de le citer comme une vérité statistique.
Ce rapport se lit donc comme un signal fort sur un problème d'exécution, pas comme la mesure exacte du taux d'échec d'un projet d'IA. Ce taux dépend de la définition retenue pour l'échec, et aucune mesure incontestable n'existe aujourd'hui. L'étude METR, randomisée, offre un niveau de preuve plus solide, mais sur 16 personnes et un seul métier.
Ce que ça change pour une PME ou une ETI
Pour une entreprise de taille moyenne, le rapport contient une bonne nouvelle. Selon le MIT, les structures de cette taille passent du pilote à la production en 90 jours environ, quand les grands groupes y mettent 9 mois ou plus. Elles comptent moins d'échelons de validation, et le dirigeant connaît souvent de près le processus concerné. Encore faut-il que le pilote porte sur le bon sujet.
Imaginons un négociant en matériaux qui veut automatiser la saisie des commandes reçues par courriel. Avant de choisir un outil, il doit savoir combien de commandes arrivent chaque jour, combien de temps prend chacune et quelles erreurs reviennent. Il doit aussi repérer les cas particuliers, comme les clients qui commandent par photo ou avec leurs propres références.
Sans ce relevé, le pilote sera jugé à l'impression, et l'expérience de METR montre que l'impression peut aller à l'inverse de la réalité. Avec lui, l'entreprise sait au bout de quelques semaines si le délai de saisie et le nombre d'erreurs ont baissé. Elle peut alors décider de généraliser, de corriger ou d'arrêter, sur des éléments vérifiables.
C'est l'objet d'un audit IA tel que nous le menons chez JUWA. Nous mettons à plat le processus réel avec les personnes qui le font, nous mesurons le point de départ et nous vérifions que l'outil envisagé pourra apprendre du contexte de l'entreprise. Pour une première lecture plus rapide, le diagnostic de maturité IA situe l'organisation et désigne les processus où un projet a le plus de chances d'aboutir. La méthode, le coût et les livrables sont détaillés dans notre guide de l'audit IA en quatre semaines.
Notre lecture de ces études est assez directe. Un projet d'IA échoue rarement à cause du modèle, et beaucoup plus souvent parce que personne n'avait défini ce qu'il devait améliorer ni comment le vérifier. Les erreurs de méthode les plus fréquentes sont détaillées dans le guide des erreurs à éviter pour lancer un projet d'IA. Le rapport du MIT place le vrai test après le pilote, quand l'outil doit apprendre de ceux qui l'utilisent.
Sources
- MIT report finds most AI business investments fail, reveals GenAI divide, Virtualization Review, 19 août 2025
- Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, METR, 10 juillet 2025